Exponential
以事件率参数描述生存时间,适用于恒定风险率这一较强但清晰的假设。
Posterior prediction · Survival analysis · Sequential updating
把患者的生存时间、右删失和预测不确定性放进同一个后验分布;当新数据到来时,用上一阶段的证据更新模型,而不是重新索取全部历史数据。
医疗事件何时发生常常未知,部分患者在随访结束时仍未发生事件;模型既要处理右删失,也要让不确定性可见。
在肿瘤、感染、心血管等临床场景中,个体结局往往是“时间到事件”问题。传统点预测难以反映模型对于患者个体的把握程度;而当不同机构或不同阶段新增数据时,原始训练数据又可能因隐私和治理原因无法重新调取。
论文覆盖五类公开生存分析数据;在线演示保留其中四个较大队列,用于预测与更新流程展示。
数据按论文规范采用完整病例,分类变量编码、连续变量标准化,并将训练阶段拟合的变换器应用到后续测试分区,避免信息泄漏。在线系统可切换 AIDS、GBCS、PBC、WHAS 四类队列,并接收同结构 CSV。
模型把临床输入映射为生存分布参数,再通过后验抽样生成个体化的生存概率与可信区间。
以事件率参数描述生存时间,适用于恒定风险率这一较强但清晰的假设。
增加形状参数,允许事件风险随时间上升、下降或保持恒定。
以参数后验而非单一点估计表示模型,并把抽样结果用于预测区间和诊断。
将每位患者的特征、观察时间与事件/右删失状态组成生存分析输入。
初训使用非信息先验形成正则化;更新时,将旧模型参数的后验均值与标准差转为当前先验。
通过 NUTS/MCMC 学习后验,同时关注 R-hat、有效样本量和采样异常;预测页展示中位生存时间和区间。
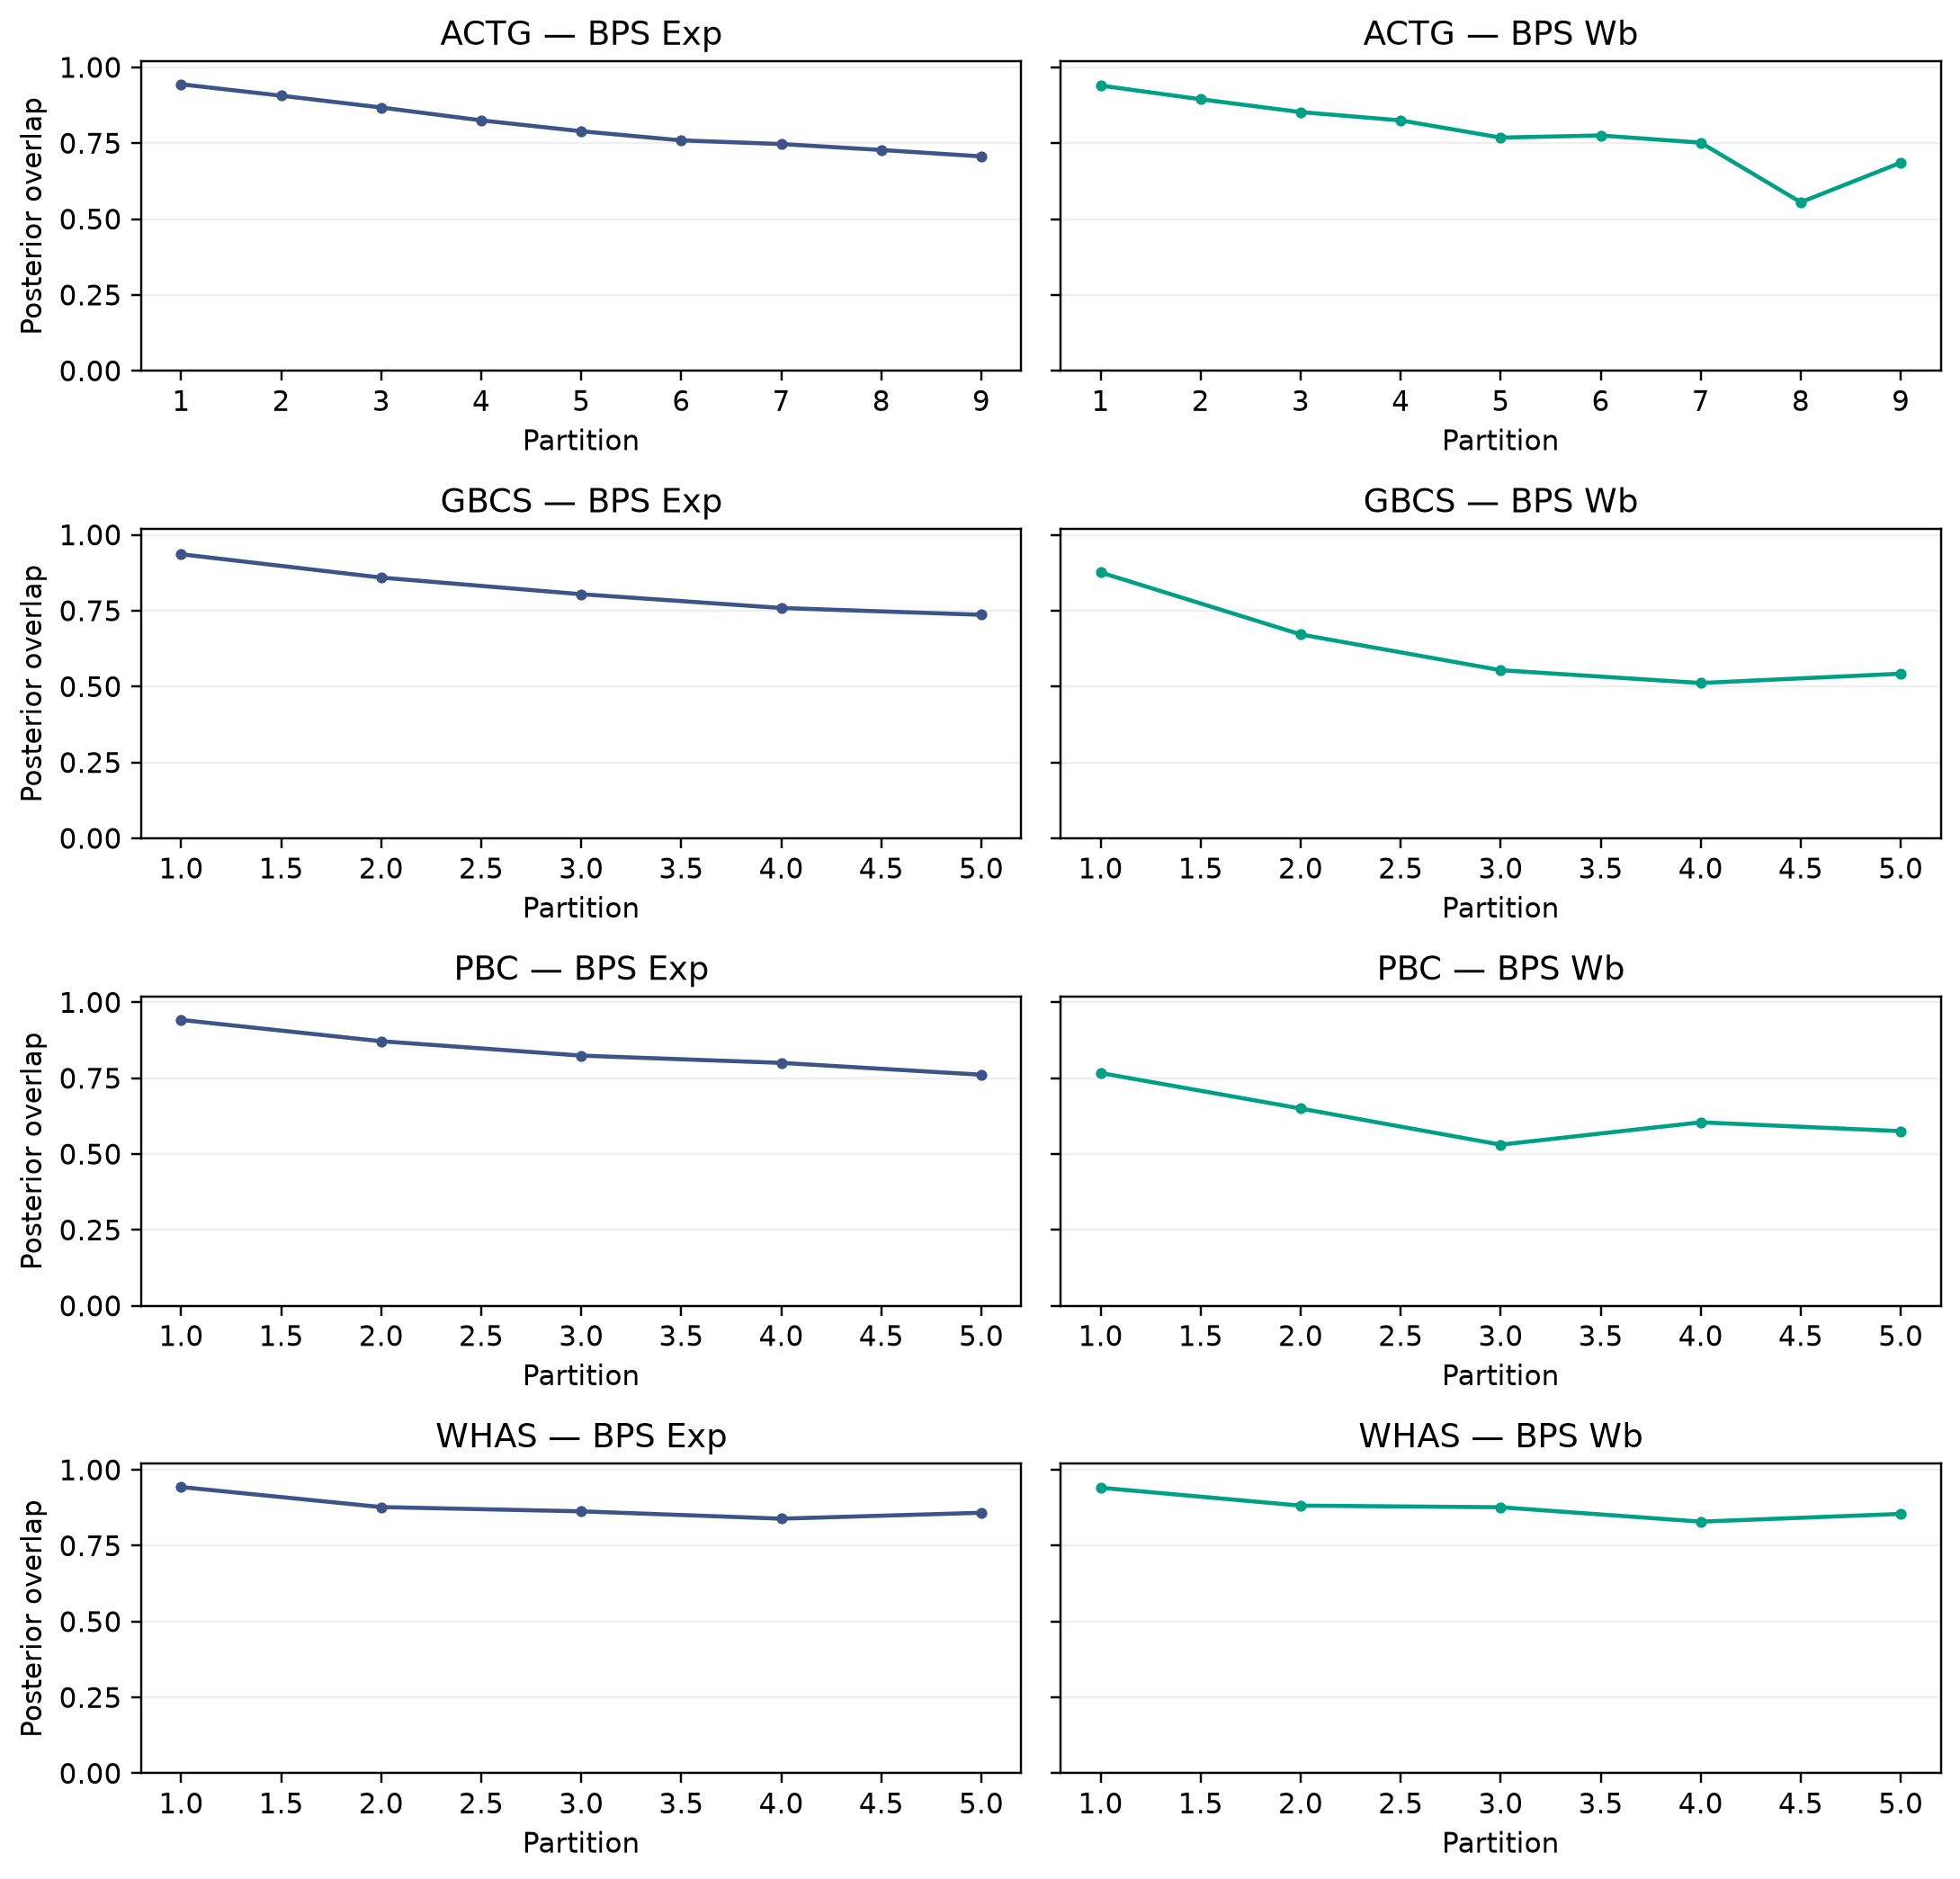
顺序更新和全量重训在同一未来分区上比较 C-index、实际等价性与参数后验的一致程度。
新阶段仅使用新增分区训练,将上一阶段参数后验作为信息先验;无需重新读取更早的数据分区。
组合所有历史分区和当前分区,从默认先验重新拟合,作为对照基准。
论文将性能差异的实用等价区间设为 C-index ±0.01;当差异的可信区间完全处于该区间内,才接受两条路径在实践上等价。除了预测性能,还通过后验分布重叠观察“性能相近”是否掩盖了参数差异。
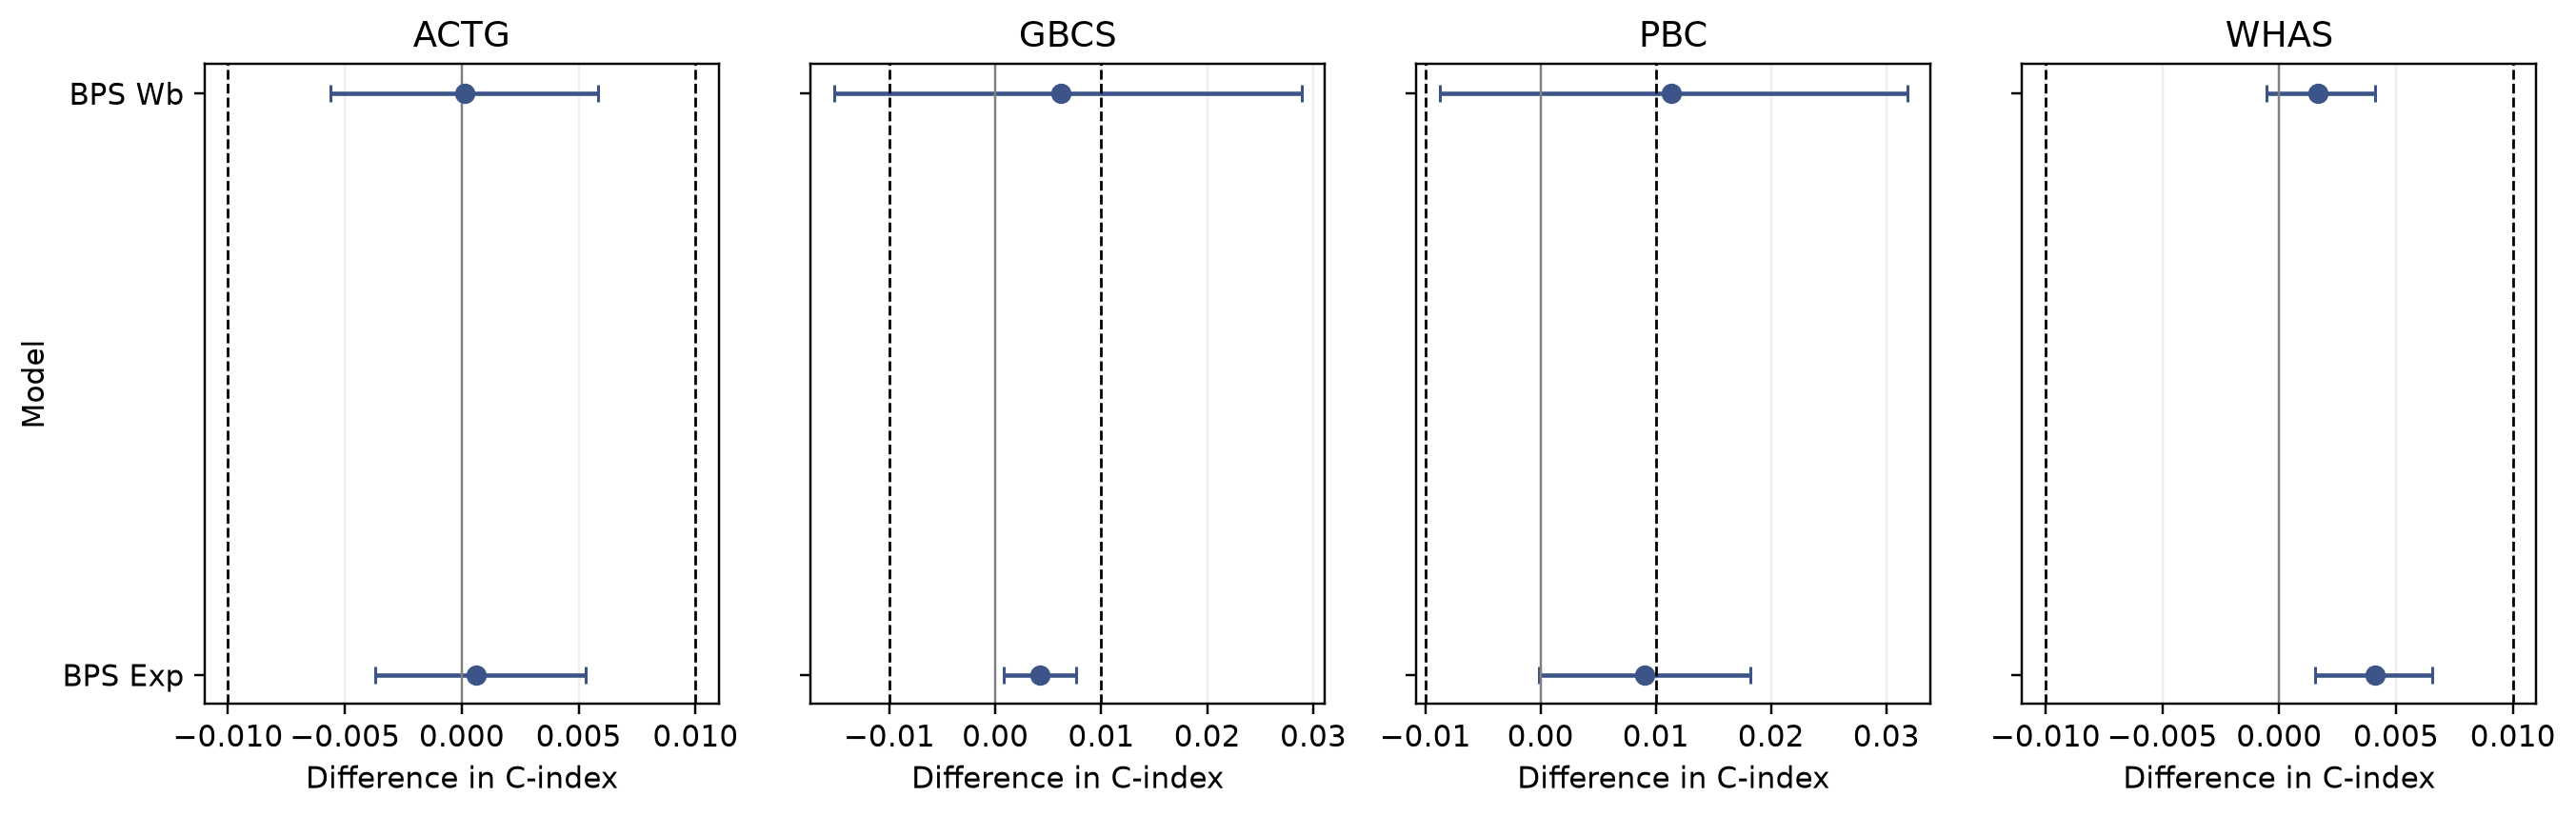
从预测表现、过拟合风险到后验参数的一致性,建立完整的证据检查框架。
研究显示:贝叶斯参数生存模型与常用 CoxPH、随机生存森林、DeepSurv 的表现相近;Weibull 贝叶斯模型在过拟合比较中表现较稳健。对于四个可更新队列,更新后的贝叶斯模型在各阶段的表现与全量训练相近;PBC 等情形仍存在等价性无法判定的结果,提示部署时不能只看单一性能指标。
在线网页把研究流程拆分为方法说明、患者预测和训练数据校验三个入口。
按队列输入患者特征、导入预测 CSV 或调用示例病例,输出生存概率、中位生存时间及 95% 后验区间。
预测服务读取保存的后验抽样,而不是仅保存一个固定系数;可导入或恢复参考模型。
训练页检查 CSV 的队列特征、时间列和事件列,设置分布类型与抽样配置后提交 MCMC 拟合。
页面与在线工具用于研究、教学和方法演示,不构成医疗诊断、预后告知或治疗推荐。实际部署前需在本地人群中验证分布假设、特征定义、删失机制、采样诊断与更新后的参数稳定性,并由临床与统计团队共同设定使用边界。
进入在线生存预测工作台,查阅公开论文;介绍视频将在素材确认后补充。